清理后继续标注
需要箭头、标签、高亮或说明时,把校正后的页面继续交给图片标注工具。
下一步上传、拖入或粘贴一张图片。可在文字提取与只清理图片之间切换,四角、旋转、清理参数和识别选区都会保留。
清晰截图可直接识别;斜拍的纸张建议先调整四角和光线。
完成识别后,这里会列出可定位的文字行。
图片和识别文字仅留在当前标签页,不会上传或写入持久缓存。开始识别后才下载引擎与语言包,并缓存这些公共资源供再次使用。加载成功后,当前页面可离线识别。请核对姓名、金额和编号。
第一版面向印刷体英文、简体中文和中英混排,不承诺手写识别、复杂公式、表格还原、弯曲书页展平,也不会用生成式内容补写看不清的字符。
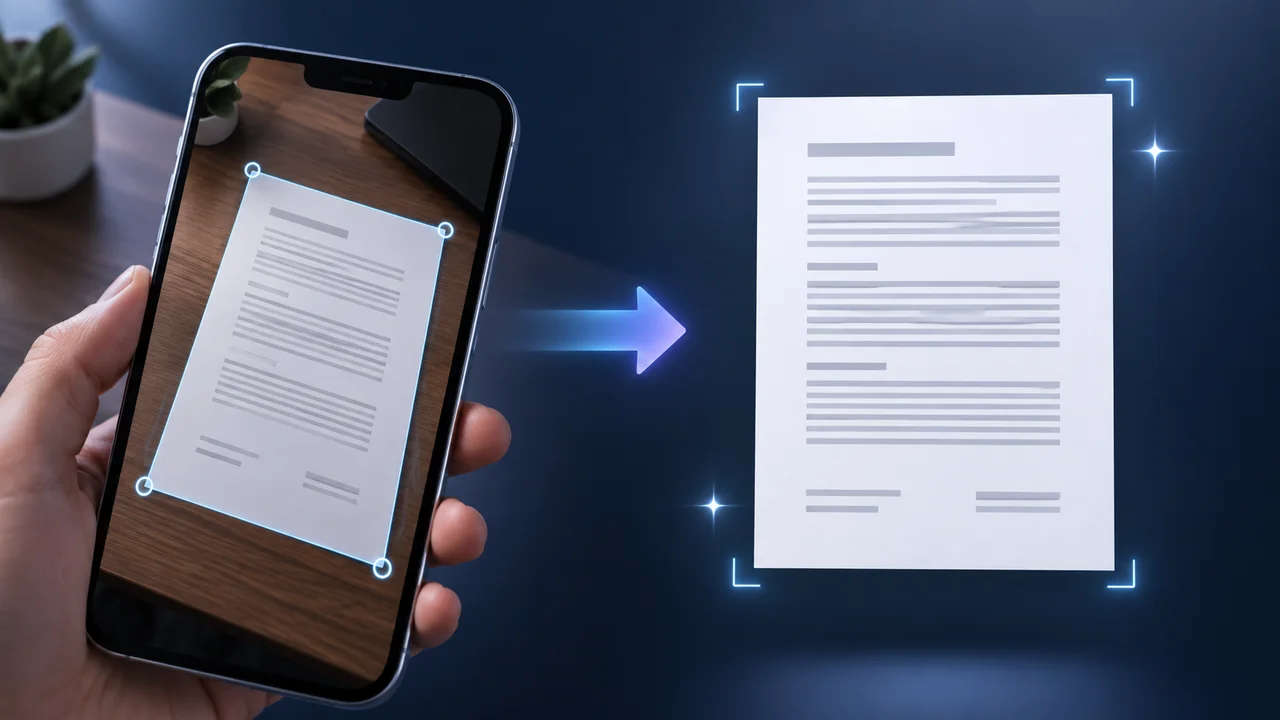
清晰截图与手机斜拍文档需要的准备不同,但最后都可以得到可校对文字。
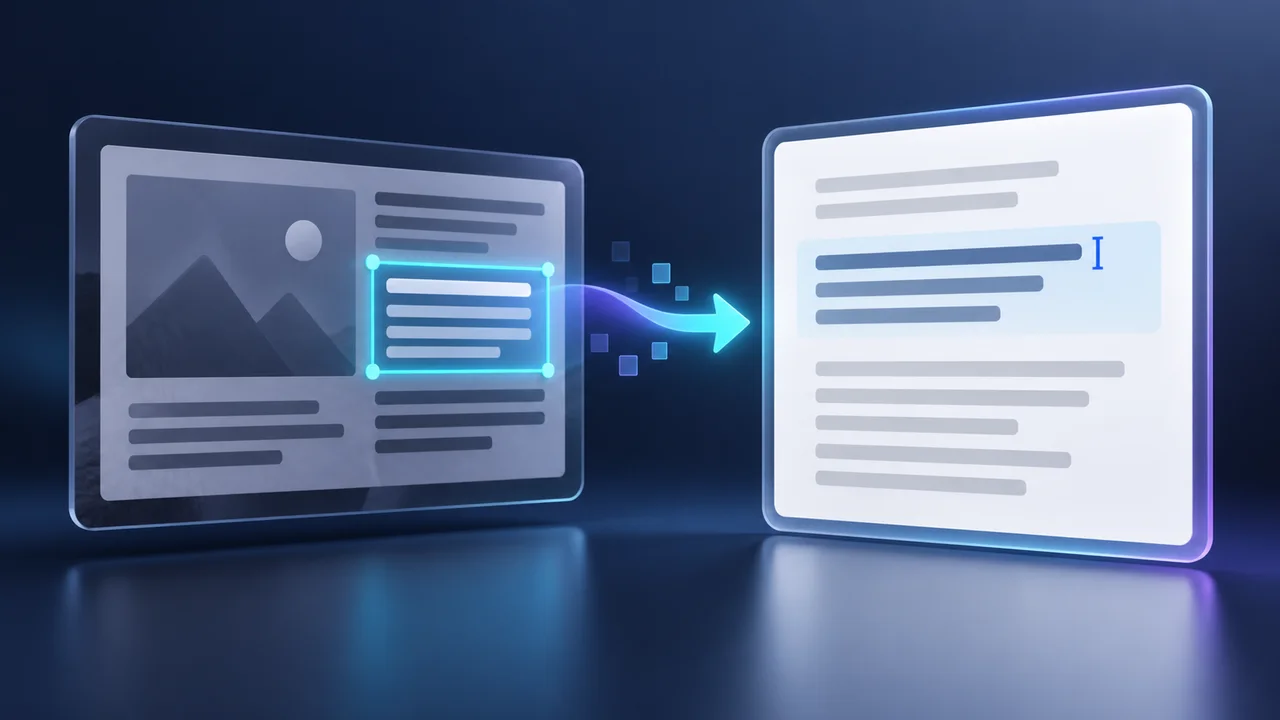
只做原图真正需要的清理,并始终用像素内容核对 OCR。
在原图与清理结果之间对比,只增加足够的背景提亮和文字加深。黑白文档是可选模式,不是清晰截图的默认处理。
选择英文、简体中文或中英混排,运行整图或区域 OCR,再核对姓名、金额、标点和换行,最后复制或下载 TXT。
根据图片文字提取、截图转文字、拍照文档矫正、隐私和准确率等真实搜索需求整理。
上传、拖入或粘贴 PNG、JPG、WebP。清晰截图保留原色,拍照文档先校正和清理;再选择识别语言以及整图或框选区域,运行 OCR 后对照原图校对结果。
通常不需要。字体清晰、尺寸足够且背景对比明显的截图,直接用原色图片转文字更稳妥。只有背景或光照确实影响识别时,再尝试灰度或黑白。
可以。选择“框选区域”,在清理结果上拖出一个框,再运行局部图片转文字。适合单个段落、小票金额、标签、图片说明或报错信息。
第一版支持印刷体英文、简体中文和简体中文加英文。尽量选择最贴近原图的语言;中英混排需要加载更多识别资源,速度可能更慢。
浏览器 OCR 需要对应语言的识别模型。页面只在点击识别后加载 Tesseract 资源,因此只做文档照片清理的用户不会被迫等待识别引擎。
使用更清晰的原图,让文字尺寸足够大;校正旋转和透视,裁掉无关内容,并适度提高对比。请与原图比较,过强的黑白处理可能擦掉浅色标点或数字。
可以把真实纸张的四个角点映射为正面矩形。自动比例根据拍摄到的四边估算目标形状;只有确定纸张确实是 A4 或美式 Letter 时,才选对应固定比例。
可以。在“原图与四角”和“清理结果”之间切换,检查背景提亮、灰度或黑白处理是否丢失浅色字迹、印章、标点或细线。
不会。图片编辑和 OCR 都在当前浏览器标签页本地运行。站点仍可能使用常规广告和统计服务,但本工具不会把所选图片发送到 OCR 服务器。
第一版不承诺手写识别、复杂公式转换、表格结构还原或原版排版复刻,重点是可人工核对和修改的印刷体文字输出。
不能。亮度、对比度、灰度和透视校正只能帮助查看已经存在的像素,无法找回拍摄时没有记录的细节,工具也不会生成式补写缺失字符。
可以下载清理后的 PNG,复制已校对文字,或下载 TXT。只需要干净图片时可以跳过 OCR,也可以把清理结果继续交给标注或实际尺寸打印工具。